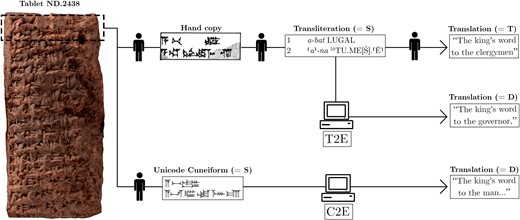
En 2023, une équipe de chercheurs de Tel-Aviv et d’Ariel présentait un système capable de traduire automatiquement l’akkadien vers l’anglais à partir de translittérations ou de signes cunéiformes encodés en Unicode. Trois ans plus tard, TabletCraft tente désormais le trajet inverse, tandis que Palaeographicum compare des millions de signes sur des photographies de tablettes hittites. De quoi accélérer la recherche, certainement, sans congédier pour autant les assyriologues.
L’étude menée par Gai Gutherz, Shai Gordin et leurs collègues ne partait pas de photographies brutes de tablettes. Deux entrées étaient testées : une translittération savante en alphabet latin, ou des signes cunéiformes convertis en caractères Unicode. Les meilleurs scores BLEU4 atteignaient respectivement 37,47 et 36,52. Des résultats prometteurs, sans correspondre ni à un pourcentage de phrases comprises ni à une note de compréhension.
Le corpus mérite lui aussi d’être regardé de près. Les chercheurs ont utilisé 8 056 textes de l’Open Richly Annotated Cuneiform Corpus, dont 7 327 néo-assyriens. Les inscriptions royales représentaient 2 997 documents et les lettres administratives 2 003. Or les auteurs le soulignaient : plus un genre est formulaire, plus la traduction automatique tend à gagner en précision.
Le détail des évaluations humaines refroidissait déjà le miracle. Sur 50 phrases fournies sous forme de translittérations, 16 étaient classées comme correctement traduites, 12 comportaient des hallucinations et 22 étaient jugées incorrectes. À partir des caractères cunéiformes Unicode, le bilan était de 14 traductions correctes, 18 hallucinations et 22 erreurs.
Un exemple suffit. La traduction humaine indiquait que le roi « ne descend pas » dans la maison du dieu. Le système supprimait la négation et lui faisait accomplir exactement l’inverse. Les chercheurs concluaient eux-mêmes que même les sorties apparemment correctes devaient rester soumises à l’examen d’un spécialiste.
Cécile Michel, assyriologue et directrice de recherche au CNRS, est revenue sur cette promesse en juin 2026. Elle insiste sur un point facilement perdu dans les titres : le programme de 2023 ne reconnaît pas directement les signes à partir d’une photographie. Une lecture experte a déjà eu lieu en amont, lorsque ceux-ci ont été identifiés et convertis en caractères exploitables par la machine.
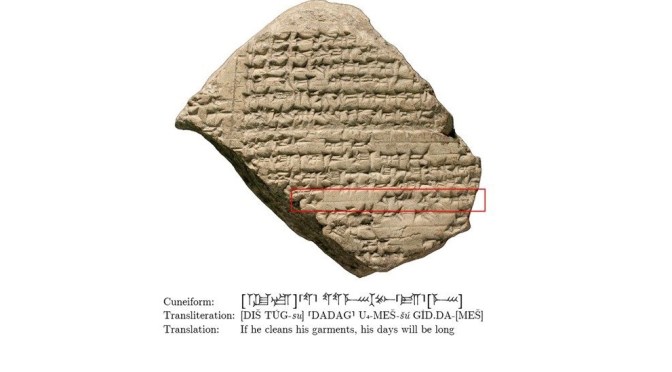
Le cunéiforme, lui, n’est pas une langue : il s’agit d’un système d’écriture employé pendant plus de trois millénaires pour plusieurs langues, dont le sumérien, l’akkadien ou le hittite, avec des signes dont la forme et la valeur varient selon les périodes et les usages. Dire qu’une IA « traduit le cunéiforme » est donc commode pour un journaliste fatigué un samedi après-midi. Scientifiquement, cela réclame quelques sous-titres.
Présenté en juillet 2026 dans les actes de l’atelier C3NLP de l’Association for Computational Linguistics, TabletCraft permet de passer de l’akkadien à l’anglais, mais aussi de l’anglais vers une translittération akkadienne, puis vers des caractères cunéiformes et le rendu visuel d’une tablette.
Le modèle, développé par Zhaohui Wang à l’Université de Californie du Sud, a été entraîné sur 58 126 phrases parallèles, utilisées dans les deux sens pour former environ 116 000 exemples. Sur un jeu de validation de 2 812 échantillons, principalement des inscriptions royales néo-assyriennes, il obtient 49,1 BLEU dans le sens akkadien-anglais et 48,5 dans l’autre.
Ces valeurs ne permettent toutefois pas de proclamer une progression arithmétique depuis 2023 : les jeux d’évaluation et les corpus diffèrent. Quant au score anglais-akkadien, il mesure la proximité avec une translittération de référence, pas une exactitude philologique absolue. TabletCraft présente ses productions comme des approximations modernes et précise qu’elles ne doivent pas être utilisées comme preuves historiques primaires.
Pour les chercheurs, le dispositif est conçu comme un assistant de brouillon et de révision, non comme un traducteur faisant autorité. Les auteurs envisagent aussi des usages pédagogiques ou muséaux : saisir un nom ou une courte dédicace, puis en obtenir une représentation cunéiforme. De la médiation, oui ; une nouvelle tablette de Ninive authentifiée par algorithme, non.
À Würzburg et Mayence, Palaeographicum travaille sur un autre problème. Présenté en mai 2026, il ne traduit pas l’akkadien : il analyse les variations graphiques du cunéiforme hittite dans les photographies numérisées du Hethitologie-Portal Mainz. Sa version actuelle donne accès à 70 000 images documentant plus de cinq millions de signes.
Repérer des formes similaires peut aider à rapprocher des fragments, comparer des habitudes d’écriture et, à terme, mieux distinguer les mains des scribes. Daniel Schwemer, professeur à l’Université de Würzburg, donne une mesure concrète du gain : comparer l’écriture de cinq fragments demandait auparavant trois jours ; l’opération peut désormais être menée en cinq minutes.
Le périmètre reste toutefois étroit : Palaeographicum travaille sur les tablettes de chancellerie hittites découvertes à Boğazkale, l’ancienne Hattousa, dont les surfaces relativement planes et l’écriture régulière se prêtent à cette analyse.
La prochaine étape annoncée consiste à entraîner le système à reconnaître automatiquement différentes mains de scribes. Pour l’heure, la machine ne remplace pas la lecture : elle réduit surtout le temps passé à chercher où regarder.
Via Clément Solym https://actualitte.com/article/133212/bibliophilie/l-ia-traduit-l-akkadien-trois-ans-apres-sait-elle-vraiment-lire-le-cuneiforme

