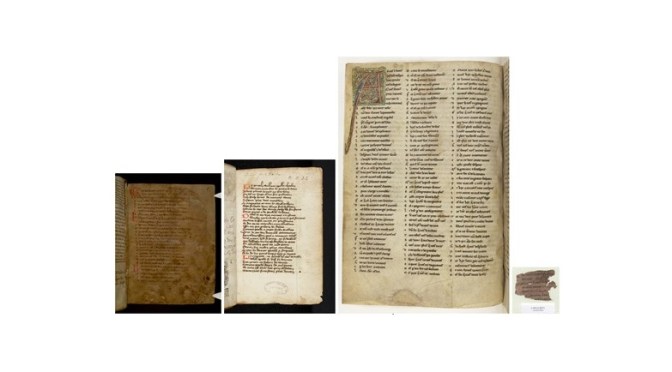
En s’inspirant de la biologie, des chercheurs français ont créé un nouvel outil de modélisation de la transmission des textes. Ils montrent que plus de 95 % des manuscrits produits ont été perdus au fil des siècles.
« Roland sent bien que sa mort est proche : sa cervelle sort par ses oreilles. Il prie d’abord pour ses pairs, que Dieu les appelle à lui, et pour lui-même ensuite à l’ange Gabriel. Pour éviter tout reproche, il prit l’olifant, et Durendal son épée dans l’autre main. […] Sur l’herbe verte, il est tombé à la renverse ; il s’est pâmé, car sa mort est proche. »
Voici un passage de la fameuse Chanson de Roland, l’un des plus grands textes médiévaux qui nous soient parvenus. C’est une des versions, mais il en existe bien d’autres puisqu’au Moyen Âge, pas d’imprimerie, les textes étaient recopiés à la main. Et lors de leur besogne, les copistes prenaient parfois des libertés en modifiant le récit. Ces transformations étaient ensuite elles-mêmes copiées et de cette manière, plusieurs versions d’une même histoire pouvaient émerger.
Cette idée de ramifications peut rappeler un arbre généalogique ou encore un arbre phylogénétique – la manière dont on représente généralement les liens de parenté des espèces vivantes. C’est d’ailleurs la manière dont, depuis le 19ᵉ siècle, les scientifiques étudient la transmission des textes. Avec un manuscrit parent qui se ramifie en plusieurs écrits dérivés, eux-mêmes se ramifiant à leur tour. Le problème, c’est qu’on a perdu beaucoup de ces ouvrages. Selon Jean-Baptiste Camps, maître de conférences à l’École des Chartes à Paris : « Ce sont des arbres dont il manque beaucoup de branches et de feuilles puisqu’il y a une portion importante de ces manuscrits, mais difficile à estimer, qui a été perdue. On s’en est rendu compte au 19ᵉ siècle, notamment par le fait que, pour certaines œuvres médiévales, par exemple celles de la littérature en ancien français – les romans de chevalerie et les chansons de geste –, on a parfois un seul manuscrit qui survit d’une œuvre très conservée, très diffusée. »
Pour combler ces lacunes, les scientifiques se sont inspirés de la biologie et de ses méthodes statistiques. Jean-Baptiste Camps est le premier auteur d’une étude parue dans PNAS Nexus, qui propose un outil de modélisation informatique pour répliquer la transmission des textes. Avec ses collègues, ils ont confronté leurs modèles aux données connues, en se concentrant sur près de 2000 manuscrits de chevalerie en français qui vont du 12ᵉ au 15ᵉ siècle. On y trouve notamment la Matière de Bretagne de Chrétien de Troyes – donc les romans du roi Arthur – ou encore les chansons de geste, comme celle de Roland.
Pour chaque roi Arthur ou Roland, dont les lecteurs peuvent encore aujourd’hui apprécier les aventures, un autre héros de la littérature ancienne a peut-être été perdu à jamais. Avant l’invention de l’imprimerie, les textes étaient copiés à la main. Ce processus entraînait des erreurs et des innovations. À l’instar des mutations lors de la réplication de l’ADN, ces modifications manuscrites peuvent servir à établir des arbres évolutifs que les philologues appellent « stemmata ». Comme ces arbres se fondent sur les copies existantes, ils ne reflètent pas l’histoire évolutive complète des textes et ne peuvent rendre compte de ceux qui ont été entièrement perdus. Jean-Baptiste Camps et ses collègues utilisent une approche issue de la science de la complexité pour estimer la quantité de littérature perdue parmi les récits chevaleresques, à partir du XIIe siècle.
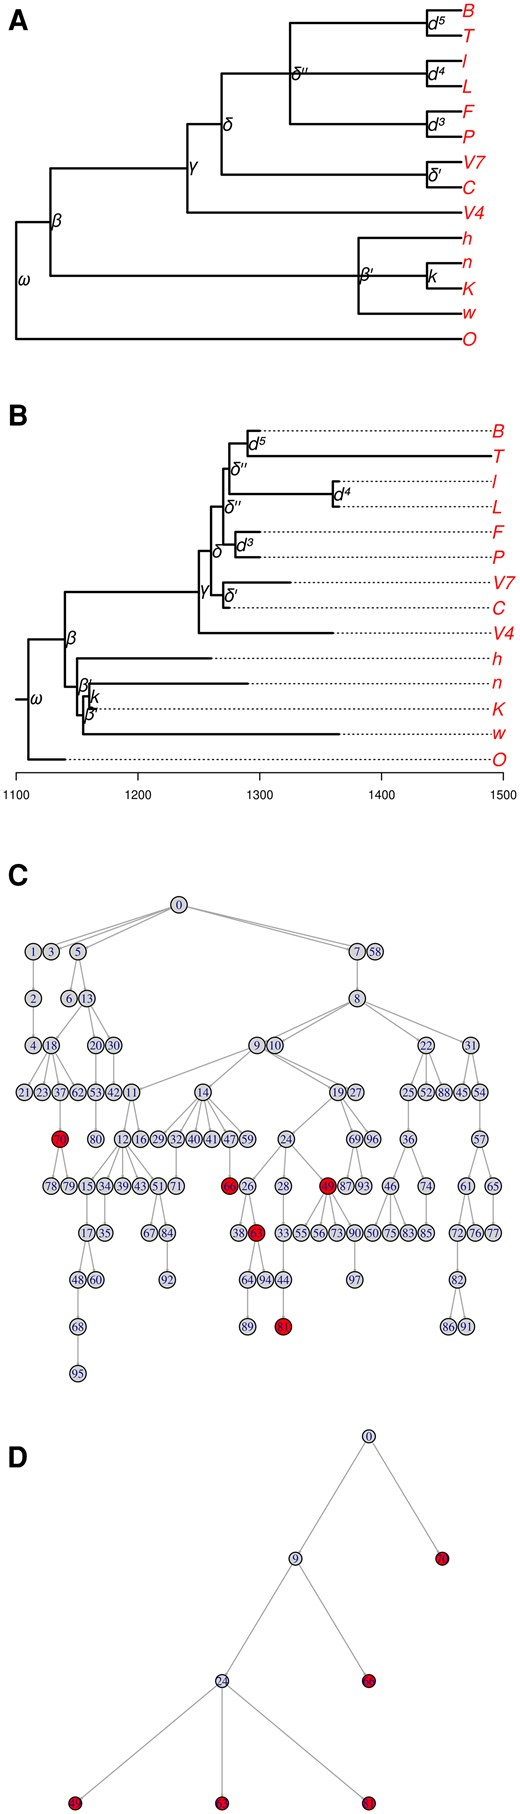
Des simulations basées sur des agents suggèrent que jusqu’à 60 % des textes et plus de 95 % des manuscrits ont pu être perdus. Le modèle révèle que les premières années suivant la création d’un texte sont déterminantes : si peu de copies sont réalisées, l’œuvre court un risque élevé d’extinction. Le modèle suggère également que, pour la plupart des textes, aucun exemplaire existant ne reflète l’état d’origine de l’œuvre ; tous les textes qui ont survécu proviennent probablement d’une branche secondaire de l’arbre généalogique d’une œuvre donnée.
On ne saura probablement jamais quelle était la version la plus ancienne de la Chanson de Roland, par exemple. Des événements apparemment aléatoires ou des contingences historiques majeures, telles que la peste noire, ont sans doute également contribué à la disparition de certains textes. Selon les auteurs, le patrimoine culturel est fragile, et ce modèle permet de comprendre comment le hasard, les contingences historiques et les choix humains ont façonné la littérature dont nous héritons aujourd’hui.

